【FX自動売買開発ログ #12】プロンプトの無駄を点検したら、地味なバグが見つかった話
 solo-ai-app.com
前回のおさらい
前回、トリガー方式にATR損切りを実装し、ドローダウンが全設定で明確に改善することを確認しました。損切りという「効くとわかっている改善」が一段落したところで、今回は少し毛色を変えて、コスト面の棚卸しをします。
プロンプトの中身を見直す
具体的に依頼したのは2点です。
- 現在のプロンプト・max_tokensの設定を見せてもらい、無駄なトークンがないか確認する
- 1回のAPI呼び出しで複数理論(ダウ理論+プライスアクション)を同時に判定させる構成に変更した場合のメリット・デメリットを整理してもらう(実装はせず検討のみ)
まず現状のプロンプト構成を確認しました。
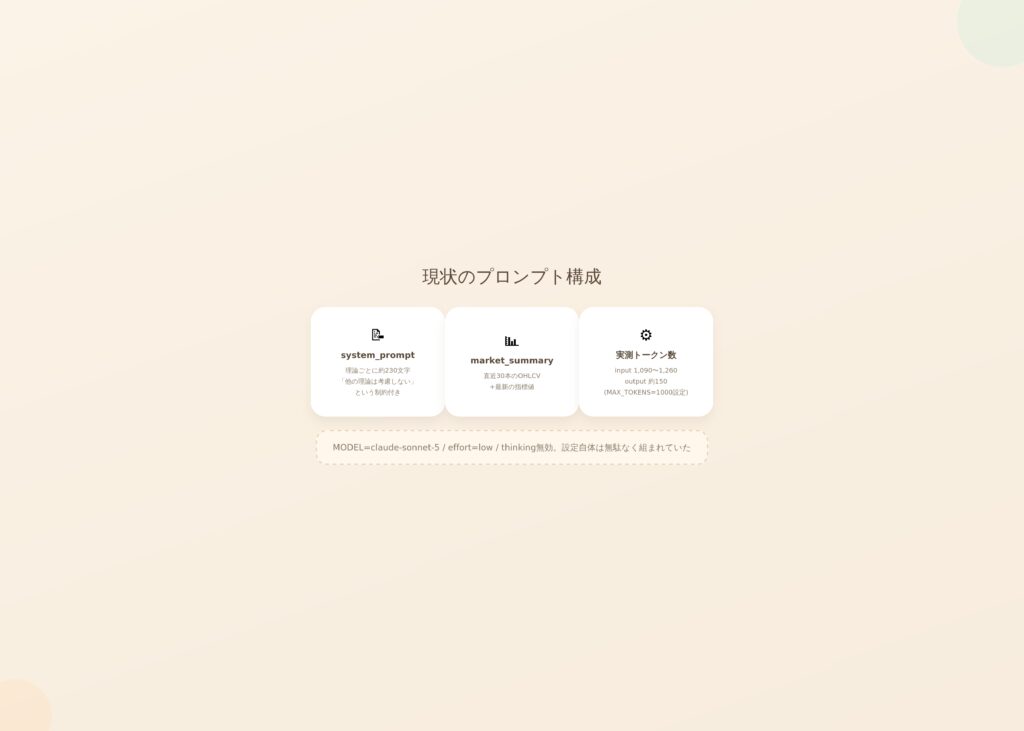
- system_prompt(理論ごと、約230文字):ダウ理論なら「ダウ理論のフレームワークのみを使って判定してください」という指示と、考慮すべき点(高値・安値の切り上げ/切り下げ、トレンド転換シグナルなど)、「他の理論は考慮しない」という制約
- user_prompt(共通):market_summaryを渡し、JSON形式のみで回答するよう指示
- market_summary:直近30本のOHLCVをCSV形式で + 最新の指標値
- 設定値:MODEL=claude-sonnet-5、MAX_TOKENS=1000、thinking無効、effort=low
- 実測トークン数:1回あたり平均 input 1,090〜1,260 / output 150程度
ここまではだいたい想定通りの内容でしたが、確認の過程で一つ、見過ごせない発見がありました。
windowパラメータが、実は反映されていなかった
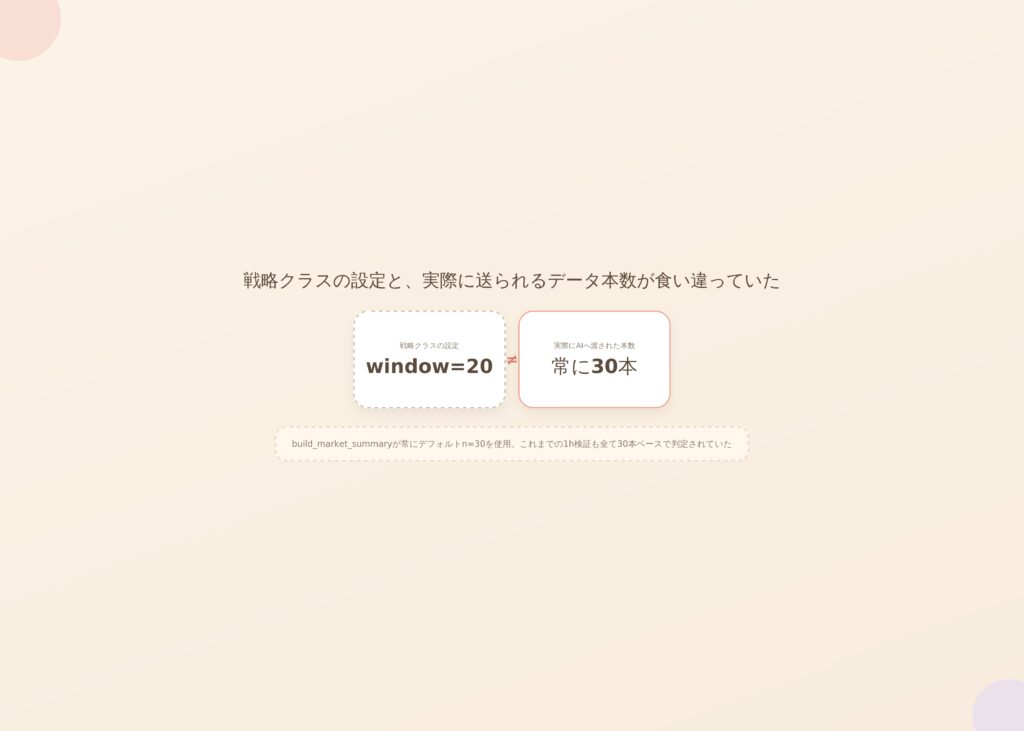
戦略クラスではwindow=20(直近20本のデータを使う設定)を指定していたはずなのに、実際にAIへデータを渡す関数(build_market_summary)は常にデフォルトのn=30本を使っていて、window=20という設定が実際のデータ本数には一切反映されていなかったことが判明しました。
これは「無駄」というよりも「設定と実態の不一致」という、地味などちらかというと厄介なバグです。無駄なトークンを使っていたという話ではなく、これまでの1h検証も含めて、意図していたよりも多い本数のデータを渡した状態で全ての判定が行われていた、ということになります。
 キャッシュキーにはwindowの値がちゃんと使われていたため、キャッシュの整合性自体は保たれていましたが、「window=20で判定させたつもりが、実際は30本を見せていた」という食い違いは、これまでの検証結果の解釈にも関わってくる話です。
その他、見つかった細かい点としては、max_tokens=1000に対して実際の出力は150トークン程度で余裕を持たせすぎていること(ただしmax_tokensは上限であり超過分に課金されるわけではないので、これは厳密には無駄ではありません)、そしてJSON形式の指示文をプロンプトキャッシュの対象にできれば理論上は節約できるものの、system_prompt自体が1,024トークン未満(sonnet-5の最小キャッシュ可能長)のため、現状の規模ではキャッシュが機能しない、という点も分かりました。
2理論を1回のAPI呼び出しにまとめたら?
もう一つの検討事項が、ダウ理論とプライスアクションを1回のAPI呼び出しで同時に判定させる構成への変更です。メリット・デメリットを整理してもらいました。
メリット
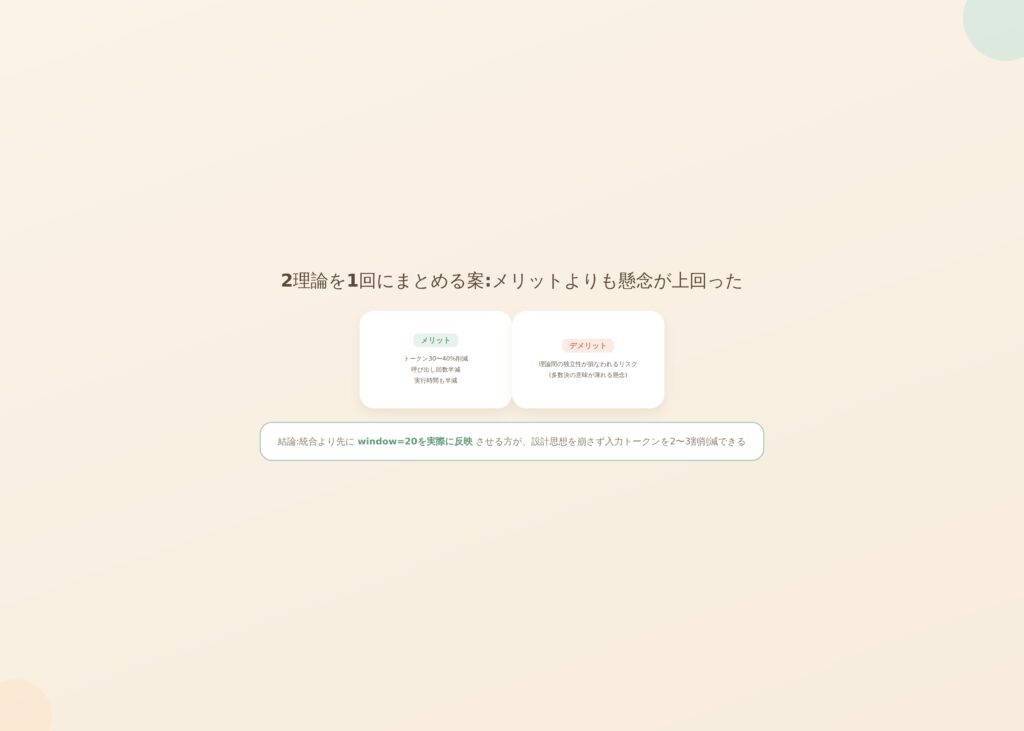
- コスト削減:market_summaryを1回だけ送ればよくなり、system_promptは両理論分の連結が必要になるものの、全体トークン数は30〜40%程度減る見込み
- 呼び出し回数半減:実行時間もほぼ半分に(1h検証は40〜50分かかっていたが20〜25分程度に短縮可能)
- ネットワークエラーのリスク低減:呼び出し回数が減る分、接続エラーの発生機会も単純に半減
- キャッシュ・ログの単純化:エントリ数が半分になり管理が楽になる
デメリット
- 理論間の独立性が損なわれるリスク(最重要):現在の設計は「各理論は他の理論を考慮せず独立に判定する」ことで、多数決アンサンブルに意味を持たせている。1回の推論パスで両方を判定させると、内部の推論がダウ理論の判断からプライスアクションの判断へ無意識に影響してしまう可能性があり、2つの判定の相関が高まり、多数決の効果(誤りの分散)が薄れる懸念がある
- JSON構造の複雑化:2理論分の結果を1つのレスポンスに含める必要があり、パースの複雑さや部分的な形式ミスのリスクがやや増える
- 理論の追加・削除がしにくくなる:将来3つ目の理論を追加する場合、共有プロンプト・スキーマ全体を都度見直す必要がある
- 部分的な再試行がしにくい:現状は理論ごとに独立してキャッシュ・エラーハンドリングできるが、統合すると一方だけ失敗した場合の扱いが複雑になる
結論:統合より先に、バグを直す
コスト・速度面では統合案に明確なメリットがある一方、「複数の独立した理論的観点を組み合わせる」というこのプロジェクトのコンセプト自体を弱めかねない、というのが一番の懸念点として挙げられました。
その上で出てきた提案は、コスト削減が目的なら、理論の統合よりも先に「window=20を実際に反映させる」対応の方が優先度が高いというものでした。30本→20本に減らすだけでも、入力トークンを2〜3割程度削減できる可能性があり、しかも設計思想(理論の独立性)を一切崩さずに効果を得られる、という理屈です。地味な話ですが、統合という大きな変更に手を出す前に、まず目の前の設定ミスを直す方が筋が良い、というのは納得感のある判断でした。
理論の統合は見送り、まずはwindowバグの修正を優先することにしました。
次回予告
次回は、実際にwindow=20を正しく反映させる修正を行い、トークン消費がどれくらい減るか、そして結果自体に影響が出るかを確認します。
※本シリーズは個人の技術検証・学習を目的とした開発記録であり、特定の投資手法や金融商品を推奨するものではありません。自動売買には元本割れのリスクがあり、掲載する内容を参考にした取引の結果について一切の責任を負いかねます。投資判断はご自身の責任で行ってください。