【FX自動売買開発ログ #3】異なる理論が、ちゃんと「違う意見」を言ってくれた
 solo-ai-app.com

前回のおさらい
前回はSTEP1(データ取得+バックテスト基盤)が完成し、SMAクロスの単純戦略で「基盤が正しく動くこと」だけは確認できました。成績はボロ負け(トータルリターン-3.96%)でしたが、それは想定通り。今回はいよいよSTEP2、複数の理論的観点をAIに個別判定させる層の実装です。
STEP2:ダウ理論とプライスアクション、2つの「判定係」を作る
投げた指示はシンプルで、「ダウ理論」と「プライスアクション」という2つの独立した判定モジュールを作り、それぞれが
{ theory_name, signal(buy/sell/neutral), confidence(0-100), reasoning }
という共通フォーマットで結果を返す、という設計です。モデルはclaude-sonnet-4-6、分類タスクなのでeffort設定は低めにしてコストを抑える方針にしました。
Claude Codeは、この設計自体はほぼ一発で通しました。
strategies/theory_dow.py(ダウ理論の判定) strategies/theory_price_action.py(プライスアクションの判定) utils/claude_client.py(API呼び出し・JSON解析・リトライ処理をまとめた共通ロジック) utils/usage_logger.py(呼び出し回数・トークン使用量をログに記録)
という構成で、JSON構造化出力についても「プロンプトで指示 → パース失敗時は正規表現でJSON部分を抽出するフォールバック」まで最初から入れてくれました。このあたりは、雑にプロンプトを投げても「壊れたときの保険」を勝手に用意してくれるあたり、地味にありがたいポイントです。
ただし、この時点ではまだ.envにAPIキーを入れておらず、動作確認は「エラーで正しく止まること」の確認止まりでした。キー未設定 → 「ANTHROPIC_API_KEYが設定されていません」というエラーで止まる、というのを見て、コードパスとしては健全という判断です。
実際にキーを入れて動かしてみた結果
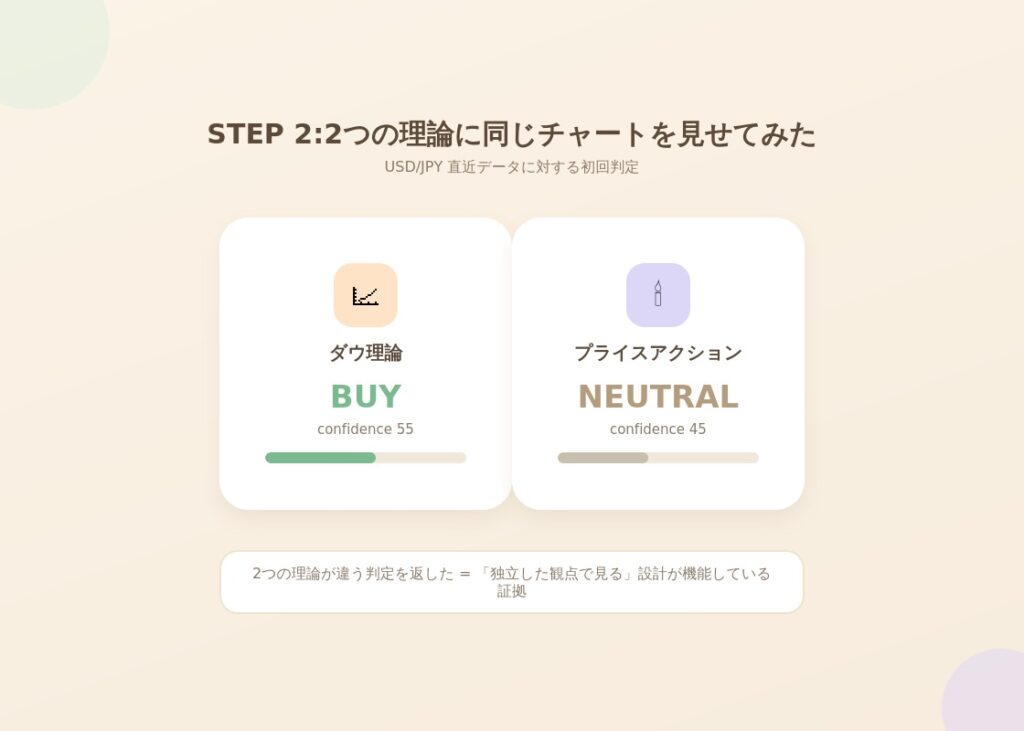
APIキーを設定してdemo_theory_judgments.pyを実行したところ、直近のUSD/JPYデータに対して
dow_theory: buy(confidence 55) price_action: neutral(confidence 45)
という結果が返ってきました。
同じチャートを見せているのに、理論が違うと判定も違う。当たり前と言えば当たり前なのですが、これを実際に自分の目で確認できたのは地味に嬉しい瞬間でした。もし2つの理論が毎回同じ判定しか返さないようなら、「理論ごとに独立した観点で見る」という設計自体が機能していないことになります。confidenceも50前後とそこそこ控えめな数字で、AIが無理に強気の判定を出そうとしていない(=それらしい理由をこじつけて自信満々に断言してこない)のも、この段階では好印象でした。
STEP3:複数の判定をどう「統合」するか
2つの理論が別々の意見を言えることは確認できたので、次はそれをどう1つのシグナルにまとめるかです。
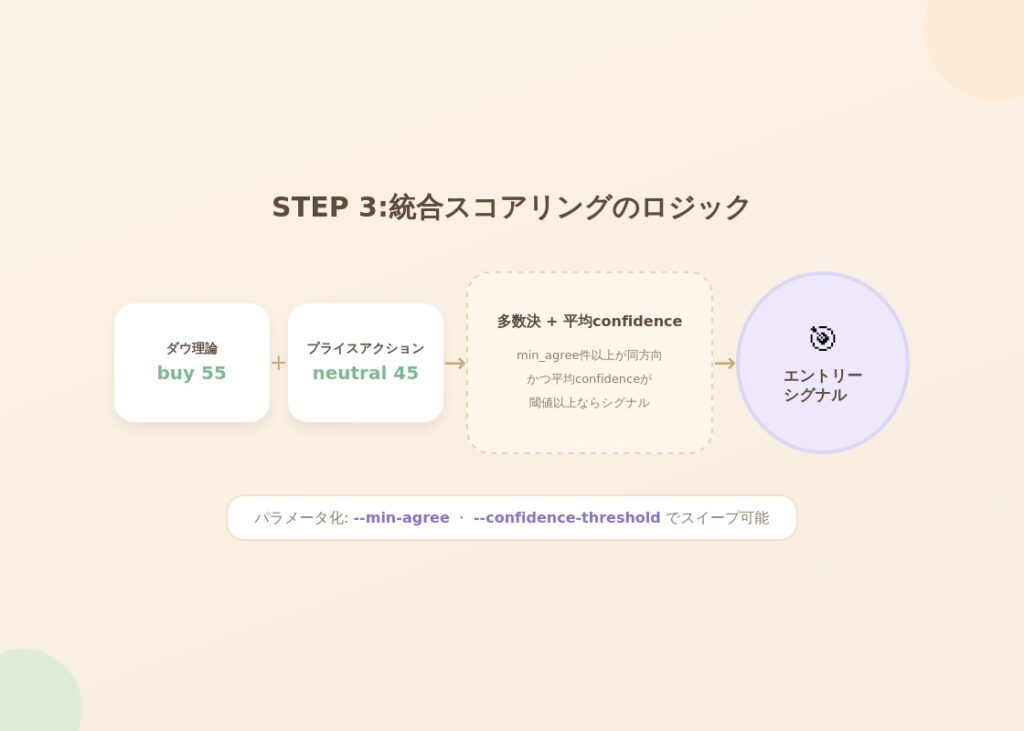
STEP3で組んだロジックはシンプルで、
- min_agree件以上の理論が同じ方向(buyまたはsell)を示していて
- その理論群の平均confidenceがconfidence_threshold以上なら
- エントリーシグナルとする
という多数決+平均confidence方式です。min_agree(必要な一致理論数)とconfidence_threshold(confidenceの閾値)はどちらもパラメータとして外から変えられるようにし、run_ai_backtest.pyで訓練期間/検証期間に分けて成績を比較できるようにしています。過学習チェック(訓練期間だけ好成績で検証期間で崩れていないか、勝率の差が20pt以上開いていないか)も、この段階で自動判定に組み込んでもらいました。
地味に効いた「キャッシュ」の設計
ここで良かったのが、理論判定結果を「日付×理論名」単位でキャッシュする設計を最初から入れてもらったことです。
min_agreeやconfidence_thresholdをいくら変えても、それは「すでに出た判定結果をどう集計するか」の話でしかなく、判定そのものをAIに聞き直す必要はありません。実際、6通りのパラメータ組み合わせで比較表を出しても、2回目以降の実行では新規API呼び出しが0回だったのを確認できました。パラメータ探索のたびにAPIを叩き直していたら、コストがすぐに膨らんでいたと思います。
小規模データで動作確認、ただし……
コストを抑えるため、直近40日分(train15本/test16本)という小さいデータでSTEP3の動作確認をしました。baseline(SMAクロス)とAIアンサンブル戦略、それぞれ訓練期間・検証期間の成績を比較表示するところまでは動きましたが、正直に言うと今回のデータ量では評価ポイントがわずか2つしかなく、パラメータをどう変えても結果が同一になってしまいました。「動くことは確認できたが、傾向を語れるレベルではない」というのが正直な現状です。
もっと意味のある比較をするには、開始日をさかのぼる・stride(判定間隔)を小さくするなどして評価ポイントを増やす必要があります。ただしそれは、その分だけAPI呼び出し回数が増えるということでもあります。
実行前に、まず「いくらかかるか」を聞いてみた
ここで一旦立ち止まりました。範囲を広げたバックテストコマンドを打つ前に、想定されるAPI呼び出し回数だけ先に見積もってもらうことにしたのです。
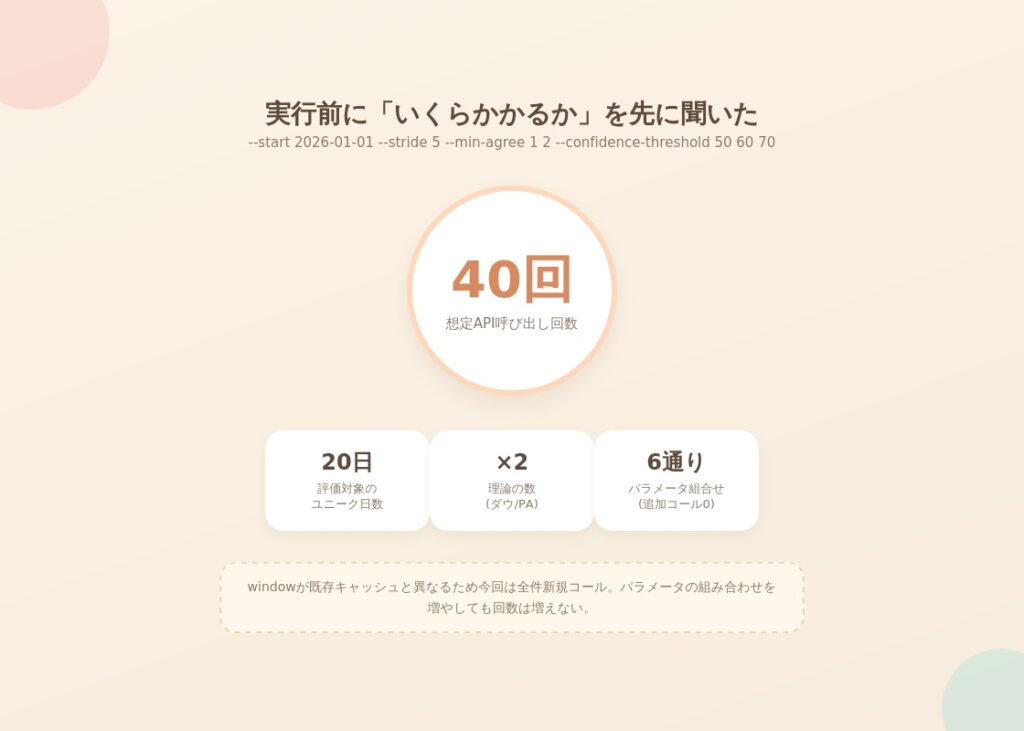
.venv\Scripts\python.exe -m backtest.run_ai_backtest --start 2026-01-01 --stride 5 --min-agree 1 2 --confidence-threshold 50 60 70
このコマンドに対する見積もりは、想定40回(評価対象20日 × 理論2つ)。min_agree・confidence_thresholdの組み合わせ(6通り)分は増えず、既存キャッシュもwindowパラメータが異なるため今回は使えず全件新規コールになる、という中身まで含めて説明してもらえました。概算のトークン数・コスト感(数十円〜百円程度のオーダー)も添えられていて、「実際にいくらかかりそうか分からないまま実行する」ことは避けられそうです。
見積もりを見た上で、実行するか・範囲を絞るかを判断する、というところで今回は区切ります。
次回予告
次回は、この見積もりを踏まえて実際にバックテストを走らせ、AIアンサンブル戦略がbaselineに対してどんな傾向を見せるかを確認します。評価ポイントを増やした分、意味のある比較ができるかどうかが焦点です。
※本シリーズは個人の技術検証・学習を目的とした開発記録であり、特定の投資手法や金融商品を推奨するものではありません。自動売買には元本割れのリスクがあり、掲載する内容を参考にした取引の結果について一切の責任を負いかねます。投資判断はご自身の責任で行ってください。